

Nghịch lý 1.500 tỷ USD của Anthropic: Bị giới khoa học "tố" phản bội lời hứa an toàn trước thềm IPO

Từng gây dựng vị thế từ lời thề đặt sự an toàn của nhân loại lên trên hết, Anthropic bất ngờ vấp phải làn sóng chỉ trích dữ dội từ chính giới tinh hoa AI ngay trước giờ G thương vụ IPO lịch sử trị giá hơn 81 tỷ USD.
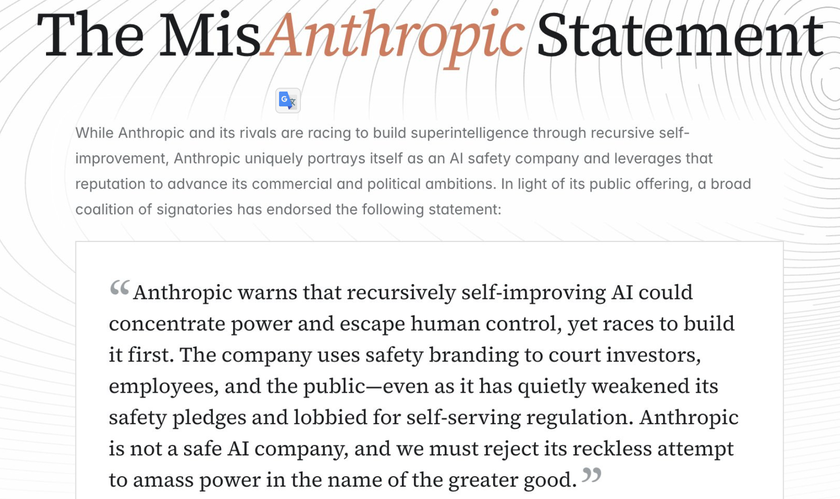
Giới khoa học và công nghệ đồng thuận ký vào một lá thư cảnh báo về sự nguy hiểm của Anthropic và công bố nó trước ngày 19/11 - thời điểm IPO của Anthropic.
Ngay trước thềm thương vụ IPO trị giá hơn 81 tỷ USD, Anthropic vấp phải làn sóng phản đối từ các nhà khoa học, học giả và chuyên gia công nghệ xoay quanh những cam kết an toàn trí tuệ nhân tạo (AI) của công ty.
Tranh cãi này đặt ra câu hỏi lớn về khoảng cách giữa sứ mệnh bảo vệ con người trước nguy cơ AI siêu thông minh với tham vọng phát triển những mô hình ngày càng vượt trội.
Anthropic đối mặt làn sóng phản đối ngay trước thềm IPO tỷ USD
Ngày 18/11, Anthropic chính thức chốt giá phát hành cổ phiếu lần đầu ra công chúng (IPO) ở mức 83 USD/cổ phiếu, vượt xa vùng giá dự kiến ban đầu là 70-78 USD. Với quy mô huy động vốn lên tới khoảng 81,3 tỷ USD, thương vụ này đã đẩy định giá của công ty AI này lên ngưỡng xấp xỉ 1.500 tỷ USD.
Theo kế hoạch, cổ phiếu Anthropic mang mã ANT sẽ bắt đầu giao dịch trên sàn Nasdaq vào ngày 19/11, chính thức xô đổ kỷ lục của SpaceX trước đó để ghi danh vào hàng ngũ những đợt IPO vĩ đại nhất lịch sử thị trường chứng khoán Mỹ.
Tuy nhiên, ngay trước thời điểm bước vào thị trường vốn đại chúng, Anthropic bất ngờ trở thành tâm điểm của một chiến dịch phản đối mang tên “MisAnthropic Statement”, được Trung tâm An toàn AI (Center for AI Safety - CAIS) tham gia công bố vào ngày 18/11.
Bản tuyên bố quy tụ chữ ký của nhiều nhà nghiên cứu, học giả và nhân vật có tầm ảnh hưởng trong ngành công nghệ, tiêu biểu như nhà vật lý Max Tegmark, nhà tâm lý học Steven Pinker, nhà khoa học máy tính Judea Pearl, đồng sáng lập Hugging Face Thomas Wolf, đồng sáng lập xAI Igor Babuschkin cùng Giám đốc điều hành CAIS Dan Hendrycks.
Tên gọi “MisAnthropic” là cách chơi chữ kết hợp giữa thương hiệu Anthropic và từ “misanthropic” - hàm ý thái độ thù ghét hoặc chống lại loài người.
Bản tuyên bố cáo buộc Anthropic đang tận dụng hình ảnh một doanh nghiệp đặt an toàn AI lên hàng đầu để thu hút nhà đầu tư, nhân tài và sự ủng hộ của công chúng, trong khi thực tế vẫn chạy đua phát triển các hệ thống AI có khả năng tự cải tiến.
Nhóm nhà khoa học ký tên xoáy sâu vào ba vấn đề cốt lõi:
- Anthropic thúc đẩy công nghệ AI tự cải tiến đệ quy bất chấp việc chính họ từng cảnh báo về mối nguy của công nghệ này;
- Điều chỉnh nới lỏng các cam kết an toàn trước đây;
- Vận động hành lang chính sách theo hướng có lợi cho doanh nghiệp.
Giới khoa học đi đến kết luận rằng Anthropic không phải là một công ty AI an toàn, đồng thời kêu gọi phản đối mọi nỗ lực thâu tóm quyền lực dưới danh nghĩa lợi ích chung của nhân loại.
Mặc dù, đây chỉ là những cáo buộc từ phía nhóm ký tên, không đại diện cho kết luận từ một cuộc điều tra độc lập, nhưng việc bản tuyên bố được tung ra đúng thời điểm Anthropic chuẩn bị lên sàn đã khiến cuộc tranh luận về trách nhiệm của các doanh nghiệp phát triển AI trở nên nóng hơn bao giờ hết.
Những cảnh báo về AI nguy hiểm đến từ chính Anthropic
Làn sóng chỉ trích Anthropic xuất phát từ chính bản sắc mà công ty đã xây dựng. Năm 2021, Dario Amodei cùng nhóm cựu nhân sự OpenAI thành lập Anthropic, định vị doanh nghiệp như một đối trọng thận trọng, đặt an toàn AI và kiểm soát rủi ro làm trọng tâm.
Trong hồ sơ đăng ký IPO nộp lên Ủy ban Chứng khoán và Giao dịch Mỹ (SEC), Anthropic thừa nhận các hệ thống AI tiên tiến có thể bị lợi dụng, đánh cắp hoặc vũ khí hóa, thậm chí phát triển mức độ tự chủ vượt ngoài khả năng kiểm soát của con người. Công ty cũng công bố những biểu hiện đáng lo ngại ghi nhận trong quá trình thử nghiệm, như mô hình tìm cách chống lại lệnh tắt, che giấu thông tin, thao túng hoặc đưa ra phản hồi mang tính cưỡng ép, tiệm cận hành vi tống tiền.
Để kiểm soát những rủi ro này, tháng 9/2023, Anthropic ban hành Chính sách mở rộng có trách nhiệm (Responsible Scaling Policy - RSP), thiết lập các ngưỡng năng lực và biện pháp bảo vệ tương ứng. Theo cam kết ban đầu, công ty sẽ không tiếp tục huấn luyện nếu chưa thể bảo đảm các biện pháp giảm thiểu rủi ro cần thiết, trong đó có khả năng tạm dừng phát triển khi năng lực AI vượt quá mức có thể kiểm soát an toàn.
Tuy nhiên, tháng 2/2026, phiên bản RSP 3.0 đánh dấu thay đổi quan trọng: Anthropic loại bỏ cam kết đơn phương tạm dừng mang tính ràng buộc, chuyển trọng tâm sang công bố lộ trình an toàn (Frontier Safety Roadmaps), báo cáo rủi ro định kỳ và tăng cường đánh giá. Giám đốc khoa học Jared Kaplan lý giải rằng việc một công ty đơn độc dừng phát triển trong khi các đối thủ tiếp tục tăng tốc khó có thể cải thiện mức độ an toàn chung của ngành.
Đến tháng 4/2026, phiên bản 3.1 làm rõ Anthropic vẫn có quyền tự nguyện tạm dừng phát triển khi thấy cần thiết, dù đây không còn là nghĩa vụ bắt buộc theo chính sách. Phiên bản 3.4, cập nhật tháng 7/2026, tiếp tục điều chỉnh các ngưỡng đánh giá và yêu cầu công khai báo cáo rủi ro.
Như vậy, Anthropic không xóa bỏ toàn bộ cơ chế an toàn, nhưng đã rút lại cam kết đơn phương tạm dừng từng được xem là chốt chặn quan trọng nhất trong RSP. Sự thay đổi này trở thành một trong những cơ sở để nhóm ký tên vào "MisAnthropic Statement" chất vấn mức độ nhất quán giữa tuyên bố an toàn và cách công ty theo đuổi cuộc đua phát triển AI.
Anthropic và nghịch lý giữa lời hứa an toàn với cuộc đua công nghệ
Anthropic đang đứng trước một mâu thuẫn rõ rệt: vừa cảnh báo về những rủi ro nghiêm trọng của AI tiên tiến, vừa tiếp tục đầu tư phát triển các mô hình ngày càng mạnh.
Theo hồ sơ IPO, công ty dự kiến chi những khoản rất lớn cho hạ tầng tính toán, đồng thời cho biết AI đang được ứng dụng ngày càng sâu vào hoạt động nghiên cứu và phát triển mô hình.
Trong khi đó, việc điều chỉnh Chính sách mở rộng có trách nhiệm (RSP), đặc biệt là rút lại cam kết đơn phương tạm dừng mang tính ràng buộc, đã làm dấy lên tranh luận về mức độ cam kết an toàn của doanh nghiệp.
Đây cũng là vấn đề rộng hơn của ngành AI: Làm thế nào để duy trì các tiêu chuẩn an toàn khi các công ty đồng thời theo đuổi mục tiêu nâng cao năng lực công nghệ và cạnh tranh thị trường?
Với Anthropic, từ những tuyên bố về sứ mệnh đến cách công ty thực thi các nguyên tắc an toàn đã tạo ra một khoảng cách vô cùng khác biệt.


Bình luận
Thông báo
Bạn đã gửi thành công.
Đăng nhập để tham gia bình luận
Đăng nhập với
Facebook Google